Nel doppiaggio dei video brevi il problema più comune non è l'assenza di voce, ma la mancata sincronia tra voce e immagini: la voce fuori campo sta ancora leggendo la frase precedente e il video è già passato alla ripresa successiva; oppure l'inquadratura si ferma sul primo piano del prodotto e la voce è finita da un pezzo. L'ordine corretto è l'inverso: prima si guarda come è montato il video, poi si decide cosa dire in ogni segmento e per quanto tempo. La sintesi vocale di PixMind trasforma ogni segmento dello script in un MP3, ma la tenuta tra voce e immagini dipende dal lavoro di suddivisione fatto prima di scrivere.
Apri la sintesi vocale, tieni a portata di mano il video breve già montato, genera e scarica ogni segmento della voce fuori campo separatamente e poi portali nel software di montaggio.
Punti chiave
- Prima divide la voce fuori campo per segmenti del video, poi scrive il testo; ogni segmento porta un solo messaggio e la durata è dettata dalle immagini.
- Limite di caratteri per generazione: 100 caratteri senza accesso o con il piano gratuito, 10000 caratteri per gli abbonati a pagamento; la pagina conserva un solo risultato alla volta, quindi genera e scarica segmento per segmento.
- La durata si misura sul risultato generato: la barra di riproduzione mostra la durata totale di ogni audio; prova prima un segmento, poi ordina l'intero video, senza formule per convertire i caratteri in secondi.
- L'inserimento della voce nel video è una fase di montaggio esterna; i sottotitoli arrivano dopo il definitivo della traccia audio, generati dal video finale con lo strumento di conversione da video a testo.
Dividi prima la voce fuori campo sul ritmo delle immagini
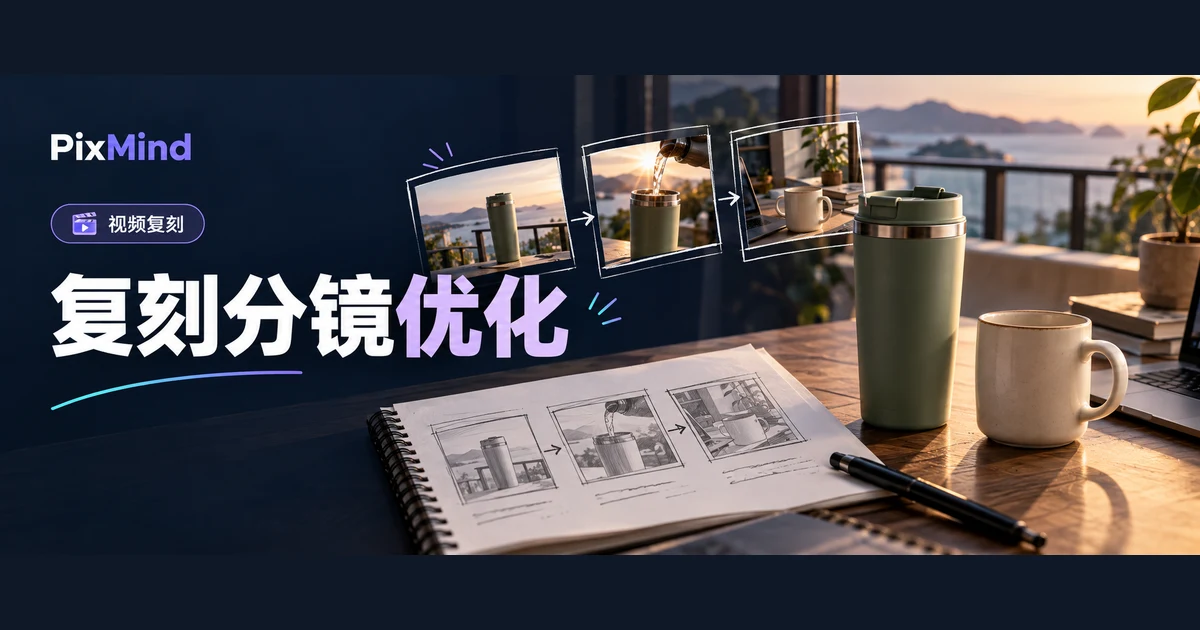
Il primo gesto del doppiaggio non è scrivere, è guardare. Rivedi per intero due volte il video montato: la prima per memorizzare l'ordine delle riprese, la seconda per ripetere mentalmente a ritmo con le immagini e sentire quante frasi ciascun segmento può contenere; poi spezza il video per funzione di ripresa.
Prendiamo un video prodotto di una quindicina di secondi, diviso in apertura, dimostrazione e chiusura:
| Segmento | Contenuto del video | Compito della voce | Durata indicativa |
|---|---|---|---|
| Apertura | Il prodotto arriva sul tavolo, la camera si avvicina | Una frase per dire cos'è e per chi è | Circa 3 secondi |
| Dimostrazione | Tre riprese d'azione: riempire, avvitare il coperchio, avviare | Una frase per azione, con l'ordine ben chiaro | Circa 8 secondi |
| Chiusura | Primo piano del risultato, fissa sul logo | Una frase con l'invito all'azione | Circa 3 secondi |
La durata di ogni segmento viene dalle immagini stesse: la voce deve riempire quella finestra, non costringere il video ad aspettarla. Scrivere prima un testo lungo e poi infilarlo nelle immagini lascia di solito un'unica strada, l'accelerazione forzata, e l'ascolto peggiora subito; il tempo per leggere un'introduzione di 300 caratteri spesso supera già l'intera durata del video.
La suddivisione ha anche un'utilità pratica: ogni generazione è limitata per numero di caratteri — al massimo 100 caratteri per volta senza accesso o con il piano gratuito, 10000 per gli abbonati a pagamento. I segmenti ricavati dallo storyboard restano in genere ben sotto il limite: un segmento, un file, perfetti per la generazione uno alla volta.
Rendi lo script scritto comprensibile all'ascolto
Nei video brevi il pubblico ascolta la voce fuori campo, non la legge. Sul piano della scrittura, due accorgimenti pesano più di tutto.
Primo: eliminare le informazioni che il video già mostra. Se le immagini stanno mostrando l'avvitatura del coperchio, la voce non deve dire “ora avvitiamo il coperchio”; se la camera è già sul primo piano del risultato, non deve ripetere “si vede quanto è vellutato il risultato”. La voce dice solo ciò che le immagini non possono dire: il nome, l'uso, il motivo dietro ogni gesto.
Secondo: un'idea per frase, con la punteggiatura a governare le pause. La virgola è una pausa breve, il punto è un respiro; le frasi corte si allineano più facilmente ai cambi di inquadratura e lasciano al pubblico il tempo di assimilare.
Esempio sul segmento di dimostrazione. Prima bozza: “Questo prodotto è semplicissimo da usare e si completa in tre passaggi: prima si mette la frutta nel bicchiere, poi si avvita bene il coperchio, infine si preme il tasto di avvio; dopo qualche decina di secondi si gusta il succo fresco.” Riscritta: “Tre passaggi e basta. Frutta dentro, coperchio avvitato, tasto premuto. Pochi secondi e il succo fresco è pronto.” La versione riscritta toglie gli ornamenti, aggiunge pause e ogni frase copre esattamente una ripresa d'azione.
Già che ci sei, scrivi numeri e codici nel modo in cui vuoi sentirli pronunciare: se “3 passaggi” deve suonare come “tre passaggi”, scrivilo direttamente in lettere; quanto alla lettura in sequenza di lettere e numeri nei codici dei modelli, fa fede il risultato generato.
Scegli la voce giusta dopo un ascolto di prova
Per la voce non esiste una risposta unica: cambiando timbro sulla stessa pagina di script cambia il carattere dell'intero video. Il metodo di scelta è semplice: con lo stesso segmento, meglio la frase di apertura, genera due versioni con due voci e decidi dopo averle ascoltate.
Nel confronto conta guardare due cose. Una è lo stile del contenuto: le dimostrazioni di prodotto stanno bene con voci brillanti e asciutte, i contenuti esplicativi chiedono un tono pacato e disteso. Due è la chiarezza: ascolta con attenzione nomi del prodotto, numeri e punti di giunzione; quale voce non ingoia le sillabe e non biascica conta più di quale voce sia più bella.
La finestra delle voci si filtra per motore e lingua e passando il mouse su una voce si può ascoltarne subito il campione; il campione dà solo il carattere del timbro, la verifica finale spetta al risultato generato con il tuo script. Non dare per scontato che un motore sia il migliore per tutto: provane un altro o due e in pochi minuti decidi.
Regola testo e velocità sulla durata misurata
Se la lunghezza della voce sia giusta non si decide a occhio: l'approccio praticabile è misurare prima un segmento, poi ordinare l'intero video.
Generato il segmento di apertura, la barra di riproduzione mostra la durata totale dell'audio; con un clic si scarica un file MP3 con un nome che inizia per pixmind-tts- e un timestamp, da ricontrollare nel lettore locale o sulla timeline di montaggio. Segna le durate di tutti e tre i segmenti e confrontale con le durate del video nello storyboard:
- La voce è più lunga del video: taglia prima il testo. Eliminare ornamenti superflui e ripetizioni è più efficace che toccare la velocità; si toglie peso, non chiarezza.
- Manca ancora poco: regola allora la velocità di poco in poco. L'intervallo dipende dal motore: il cursore del motore Microsoft va da -100% a +100% (predefinito 0), il motore Volcano da 0.8x a 2.0x (predefinito 1.0x), MiniMax da 0.5x a 2.0x (predefinito 1.0x). Procedi a passi piccoli: a ogni modifica rigenera e riascolta.
- La voce è più corta del video: non serve necessariamente rallentare per riempire. Lasciare un paio di secondi di video senza voce spesso funziona meglio dell'inseguire ogni inquadratura frase per frase.
Qui non trovi la formula “quanti caratteri valgono quanti secondi”, perché queste formule non sono affidabili: ogni voce ha una sua velocità di base, le pause della punteggiatura e la lettura dei numeri cambiano la durata reale, e la stessa frase con due voci può durare anche un bel pezzo in più o in meno. Invece di memorizzare formule, misura il segmento di apertura e usa quella durata reale come riferimento.
Nella generazione a segmenti resta la coerenza: tutti i segmenti dello stesso video usano la stessa voce e lo stesso set di parametri, così il ritmo è uniforme. Cambiando motore, velocità e volume tornano ai valori predefiniti: annota i valori regolati prima di toccare; la pagina conserva un solo risultato alla volta, quindi genera un segmento, scaricalo e passa al successivo.
Inserisci la voce nel software di montaggio e completa i sottotitoli
L'MP3 diventa video finito solo nel software di montaggio: questa fase avviene fuori da PixMind, con qualsiasi programma, secondo un flusso comune:
- Crea il progetto e importa le immagini e i tre MP3 della voce.
- Allinea ogni segmento della voce alle immagini corrispondenti secondo lo storyboard, lasciando un piccolo vuoto in corrispondenza dei cambi di inquadratura, perché la voce non venga troncata dal taglio.
- Riascolta dall'inizio e verifica che volume e ritmo siano uniformi tra i segmenti.
- Dopo la conferma esporta il video finito.
I sottotitoli si fanno dopo questa fase e sempre in base alla traccia audio definitiva. Usare direttamente il testo dello script come sottotitoli porta a una time line fuori sincrono con la voce finale: dopo tagli, modifiche e aggiustamenti di velocità, inizio e fine di ogni frase sono ormai cambiati. Il metodo è consegnare il video finito con la voce già montata allo strumento da video a SRT, generare dal video stesso il file di sottotitoli con i time code e reimportarlo nel software di montaggio per controllare nomi propri e spezzatura delle frasi.
Domande frequenti
Voce troppo lunga: prima la velocità o prima il testo?
Prima il testo. Eliminare ornamenti e informazioni già mostrate dal video basta nella maggior parte dei casi; la velocità si ritocca di poco solo quando non c'è più nulla da tagliare, perché esagerare rende l'articolazione frettolosa e sfuma i punti salienti. Dopo la modifica rigenera e controlla l'effetto con la durata sulla barra di riproduzione.
Meglio generare tutto d'un fiato o a segmenti?
Per segmenti, seguendo le inquadrature. Un testo lungo e unico urta contro il limite di caratteri per generazione — 100 per volta senza accesso o con il piano gratuito, e la parte in eccesso non viene generata — e la pagina conserva comunque un solo risultato alla volta, quindi un testo lungo andrebbe comunque spezzato e scaricato a segmenti. Suddividere per storyboard rispetta il limite e fa combaciare la durata di ogni segmento con le immagini; in fase finale si ritocca solo il segmento che non funziona.
In quale fase preparare i sottotitoli dopo aver generato la voce?
Dopo il definitivo della voce e l'inserimento della traccia nel video finito. I time code dei sottotitoli devono seguire la voce finale: si generano dal video composto con lo strumento da video a SRT, non dal testo dello script pre-generazione. Ricevuto il file dei sottotitoli, reimportalo nel software di montaggio e controlla nomi propri e spezzatura delle frasi.
Parti dalla frase di apertura della voce fuori campo
Non aspettare lo script completo. Apri il tuo video già montato e scrivi solo il segmento di apertura: una frase che dica cos'è e per chi è. Incollalo nella sintesi vocale, genera, ascolta, guarda la durata. Se il primo segmento regge, tutti gli altri non sono che la ripetizione dello stesso giro.