对话 + 环境音
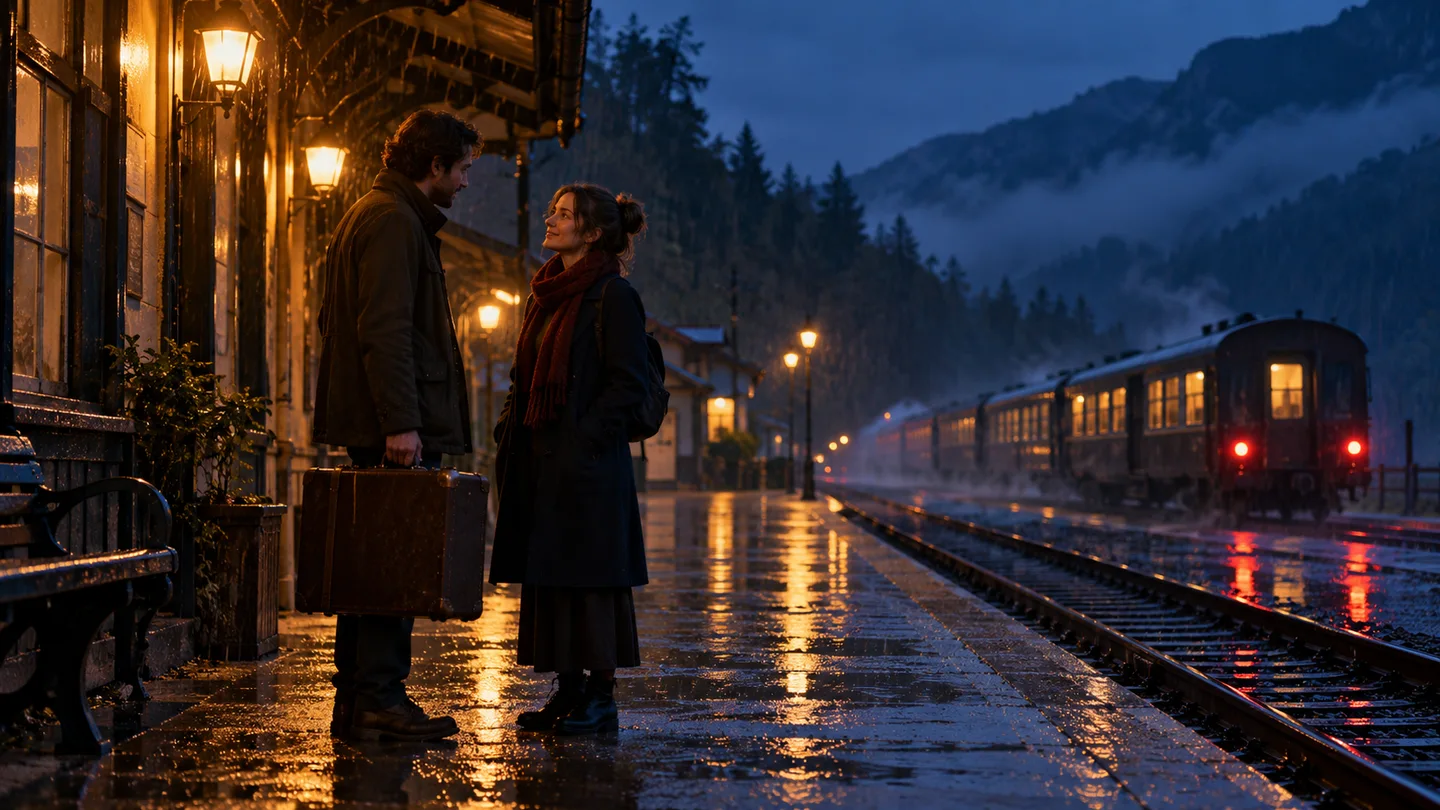
雨中站台对话
0:14生成一段 14 秒的黄昏火车站台场景。第 2–5 秒,女声温和地问:“这班车还要等多久?”第 6–10 秒,男声轻笑着回答:“大概二十分钟吧,正好陪你看会儿雨。”背景有持续的细雨声、远处列车进站的鸣笛和行李箱滚轮声。不要音乐。
字节跳动 · 场景音频生成
写下台词,也写出声音里的世界
一段带着咖啡馆氛围的对话,一句有雨声陪伴的旁白,或一个动作发生时的音效。Seed Audio 1.0 能根据场景描述,把语音、环境声与声音细节生成在同一条音轨里。
使用 SEED AUDIO 1.0 创作
描述场景和准确台词,按需添加参考素材,生成后即可试听和下载。
音轨含有人声台词时,可下载带时间轴的字幕。
在这里试听你的场景
生成后可在这里试听、下载音频,并导出字幕。
真实生成音频
以下音频全部由 PixMind 上的 Seed Audio 1.0 从一段文字提示词直接生成,未经剪辑。复制提示词即可复现场景。
对话 + 环境音
生成一段 14 秒的黄昏火车站台场景。第 2–5 秒,女声温和地问:“这班车还要等多久?”第 6–10 秒,男声轻笑着回答:“大概二十分钟吧,正好陪你看会儿雨。”背景有持续的细雨声、远处列车进站的鸣笛和行李箱滚轮声。不要音乐。
旁白解说
生成一段 12 秒的深夜城市天台旁白。第 2–10 秒,低沉的男声缓缓地说:“凌晨两点的城市终于安静下来,霓虹在雾气里晕开,像一场不肯醒来的梦。”背景有轻柔的风声、远处的车流声和偶尔的风铃轻响。不要音乐。
广告配音
生成一段 12 秒的智能手表广告配音。第 2–6 秒,充满活力的女声说:“全新 AirFit 手表,十四天超长续航,健康监测一步到位。”第 7–10 秒,她加重语气说:“现在下单,立减两百。”背景有轻快的电子提示音和收尾的清脆叮声。不要响亮的音乐。
音效拟音
生成一段 10 秒的清晨早餐铺声音。第 1–3 秒,油锅里的油条滋滋作响。第 4–6 秒,蒸笼掀开,白雾腾起伴着轻响。第 7–9 秒,远处传来自行车铃铛和邻桌瓷碗轻碰声。不要人声对白,不要音乐。
一个场景,多种声音
把人物表演和周围环境放在一起描述,可以从下面的提示词开始,改成自己的场景。
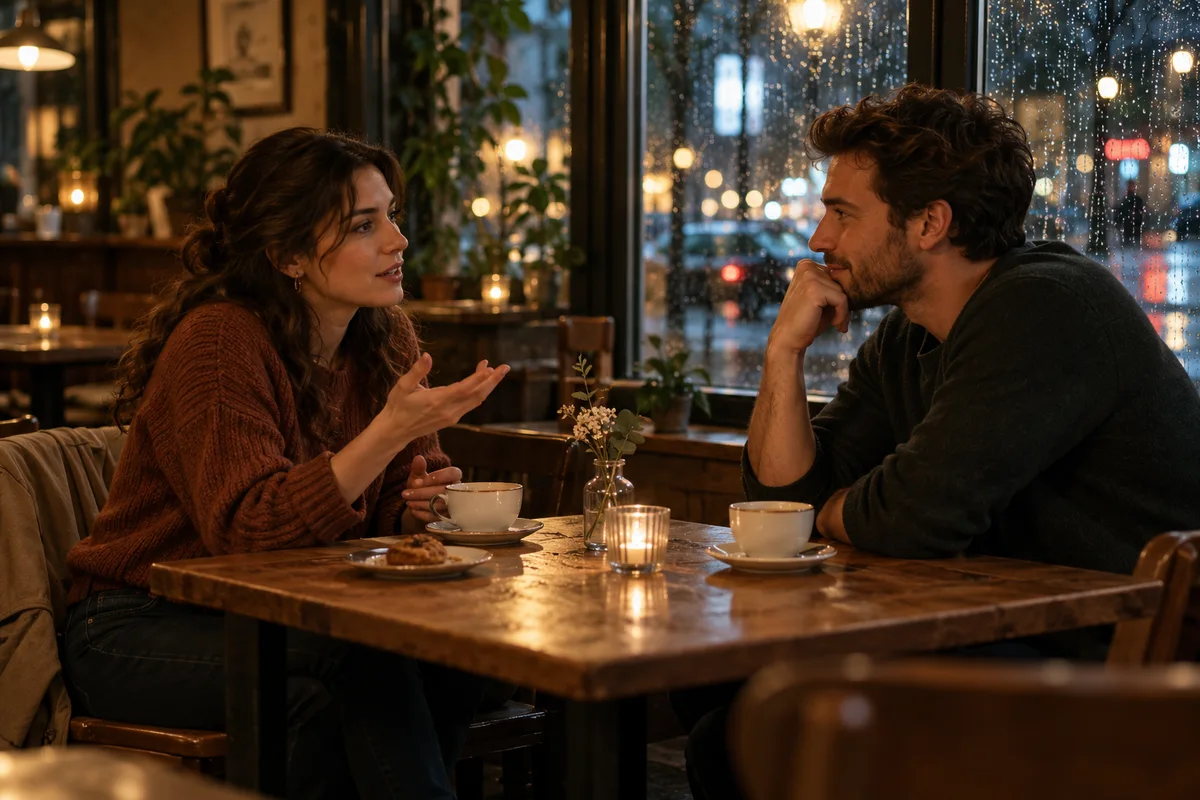
图片用于展示场景与提示词思路,并非模型生成的音频结果。
角色对话 + 环境氛围
安静的咖啡馆、热闹的街头、空旷的大厅,会让同一句对话听起来不同。
写明每个角色的台词、声音和说话方式,再补充周围的声音。Seed Audio 可以把对话和背景氛围一同生成在一条音轨里。
生成一段 12 秒的咖啡馆场景。第 2–5 秒,女生轻声问:“我们在这儿等等吧?”第 6–9 秒,男生回答:“等雨停了再走。”窗外有轻柔雨声,室内有轻微杯碟声和低弱环境声。不要响亮的音乐。
图片参考生成音频
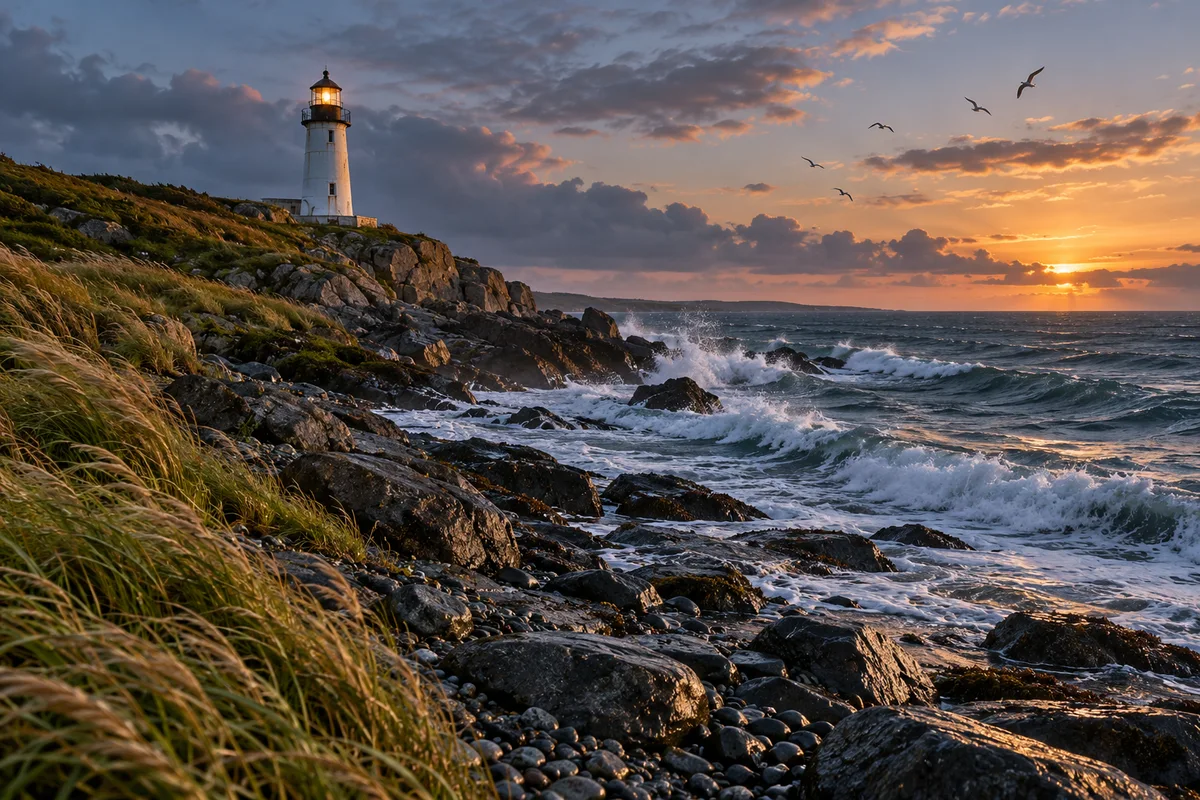
一片海岸,能让人想到风、海浪和远处的海鸟。
上传一张图片,引导音频生成,再写下需要的声音或台词。也可以截取视频关键帧作为参考,生成后把音轨加入自己的剪辑。
为这张图片生成 15 秒的海岸环境声。风吹过草丛,海浪拍打礁石,远处偶尔传来海鸥叫声。不要人声和音乐,让浪声自然起伏、渐弱。
动作音效 + 时间安排
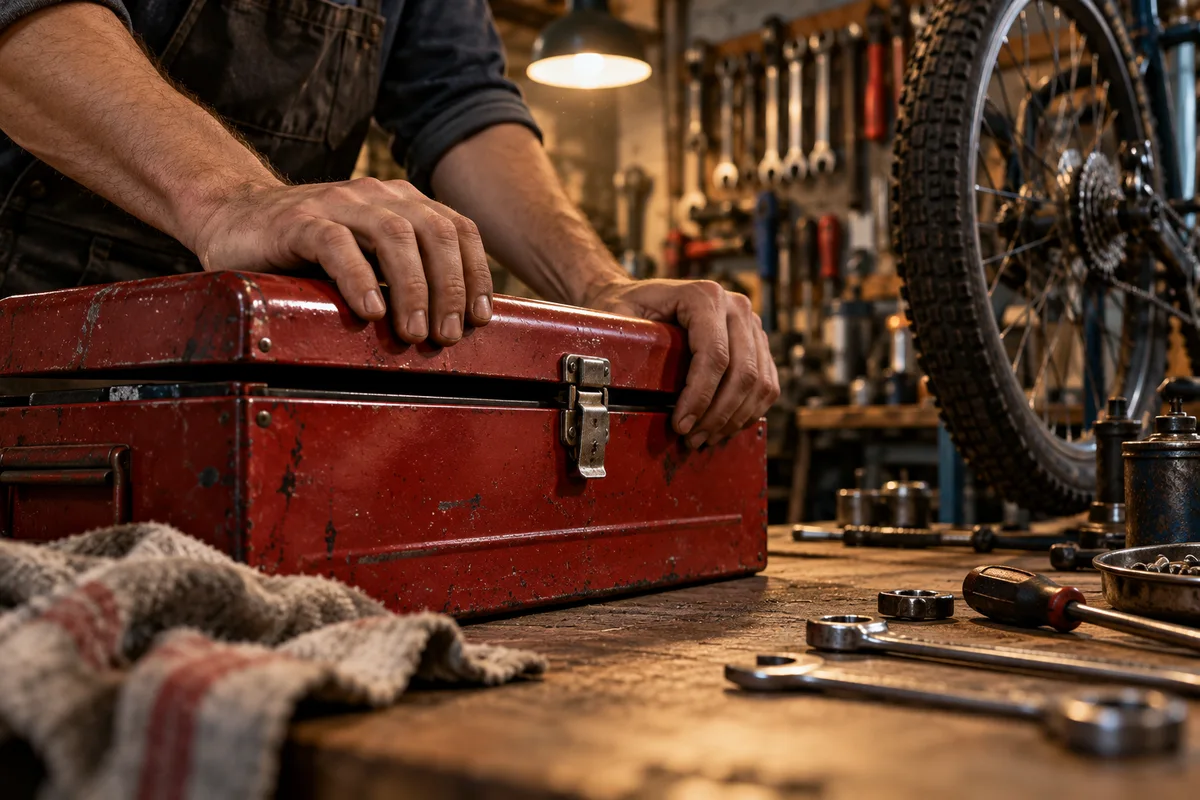
锁扣轻响,工具箱合上,房间又回到安静的背景声。
描述物体、动作、材质和空间,塑造需要的音效。用自然语言写下时长与声音出现的时间,也可以单独生成一个声音,再加入更完整的剪辑。
生成一段 8 秒的自行车维修间声音。大约第 2 秒,金属锁扣咔哒一响。大约第 3 秒,红色铁皮工具箱合上,发出结实的撞击声。几件工具轻轻晃动,随后回到安静的室内环境声。不要人声和音乐。
场景应用案例
按你要完成的任务选择案例。每个案例都提供参考画面、声音安排和可改写的提示词,方便直接用于音频创作。
以下是场景参考与声音脚本思路,可在上方生成器中生成并试听自己的音频。
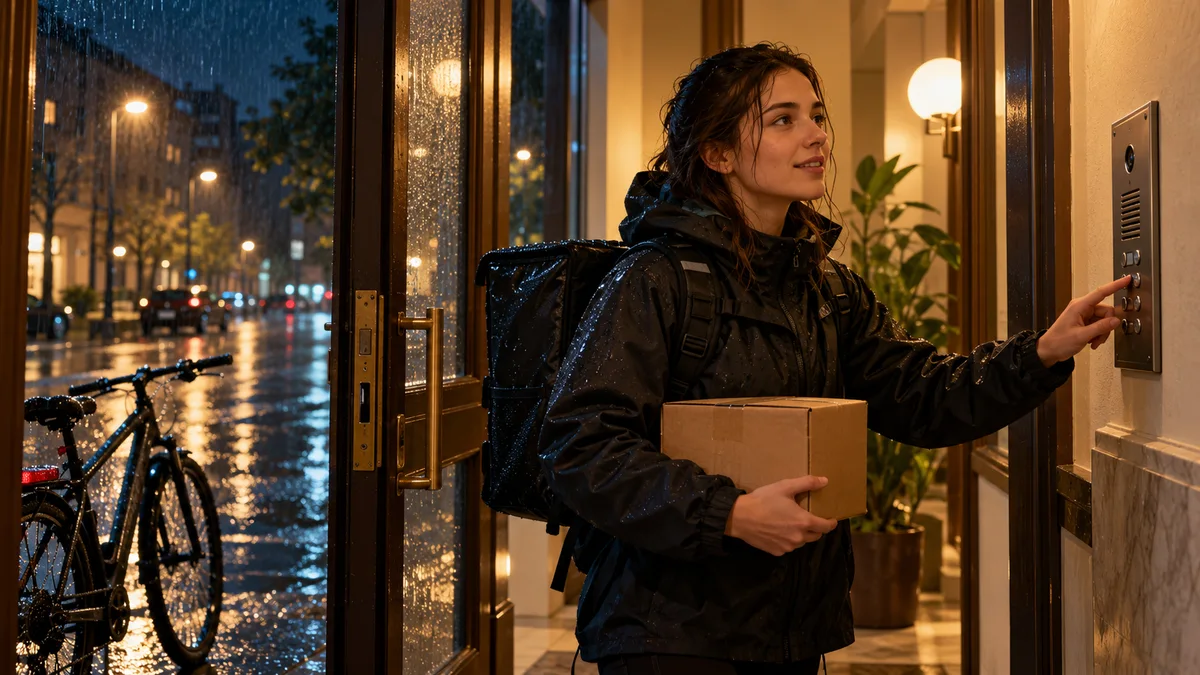
为一段雨夜送货镜头补上台词、脚步和环境声,交代时间、地点与人物动作。
可以截取视频关键帧作为图片参考,生成后把音轨放到原视频下方,在编辑器中调整时间位置。
生成一段 12 秒的中文雨夜送货场景。第 0–2 秒是轻柔雨声、湿地脚步声,随后自行车停下。第 2–5 秒,女生清晰地说:“您的快递到了。”第 6–9 秒,对讲机里传来温和男声:“谢谢,进来吧。”最后加入轻微开门声。让雨声保持在人声之下,不要音乐。
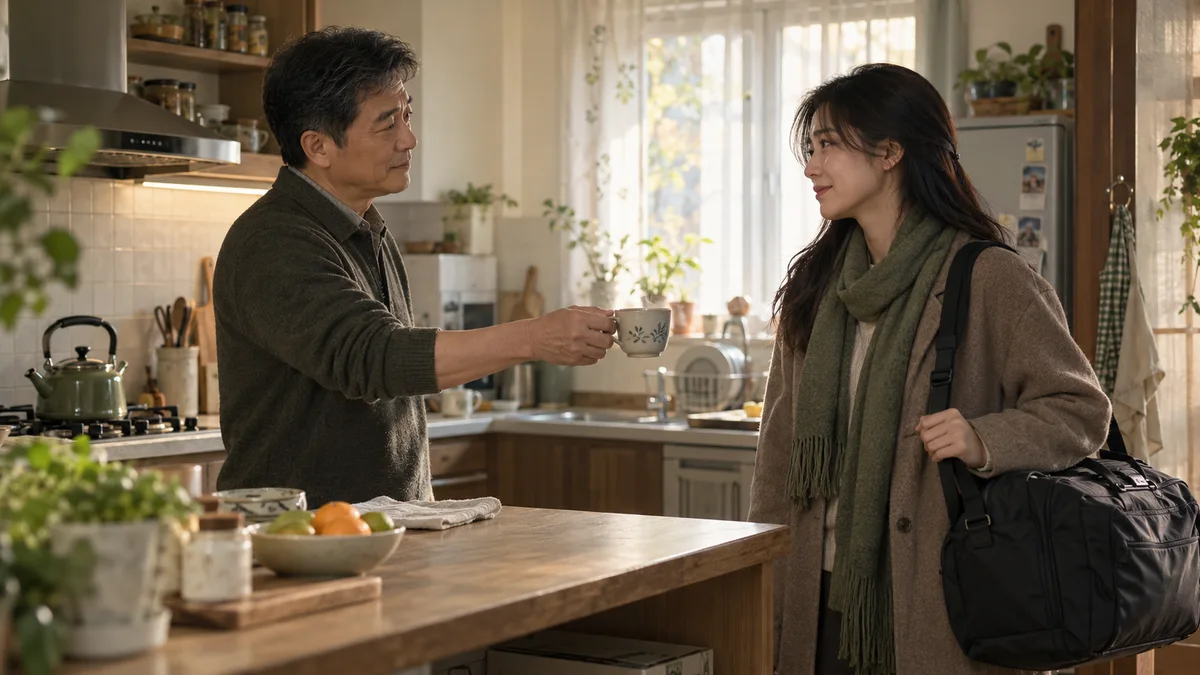
让父女告别的一小段对话带上各自的声音、自然停顿和厨房背景。
在提示词中分别交代人物的声音和说话方式。需要用声音样本保持角色音色时,切换到音频参考模式,按上传顺序引用样本。
生成一段 14 秒的中文生活短剧场景。中年父亲的声音低沉温和,成年女儿的声音清晰、放松。背景有轻微烧水声和厨房环境声。第 2–5 秒,父亲轻声问:“东西都带齐了?”第 6–10 秒,女儿带着笑意回答:“就差你泡的这杯茶。”稍作停顿后,有轻轻放下茶杯的声音。背景保持克制,不要音乐。
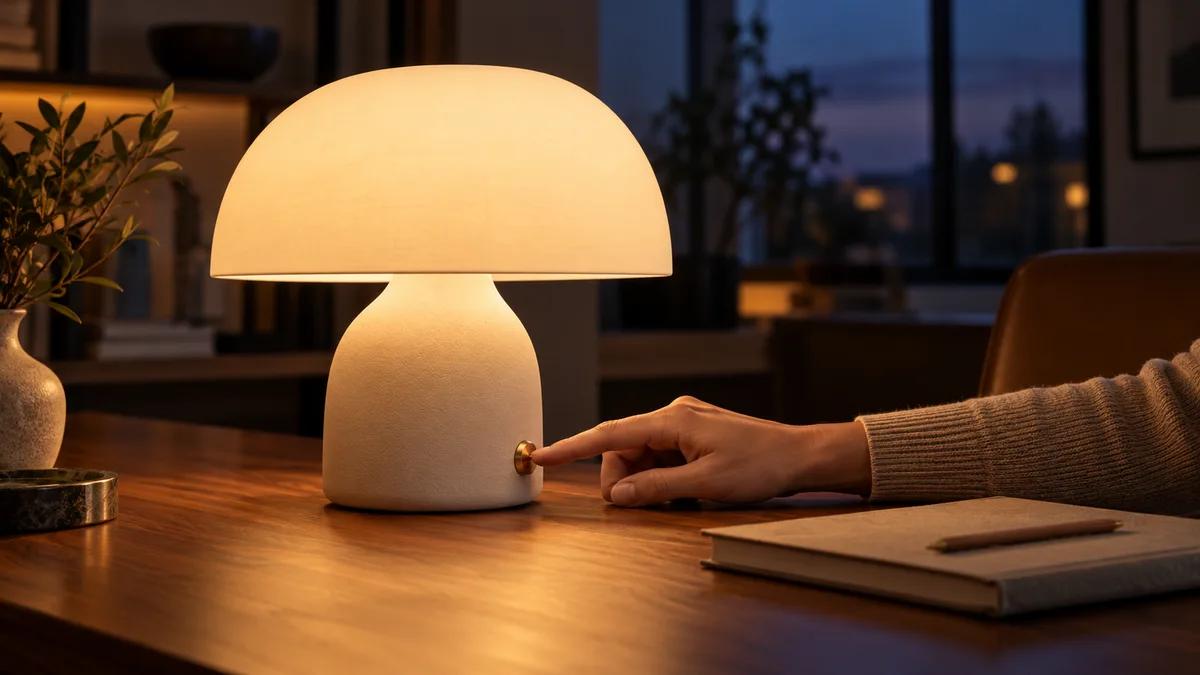
用一段简短旁白、一次开关声和轻柔配乐,为台灯宣传片搭好声音。
把准确广告文案放进引号,说明音乐应低于人声。生成后下载音轨和可用的 SRT 字幕,再与产品镜头合成。
生成一段 12 秒的中文台灯广告音频。大约第 1 秒有轻微金属开关声,随后简洁、轻柔的纯音乐渐入。第 2–9 秒,平静、自信的女生说:“一束刚好的光,一点思考的空间。把时间,留给重要的事。”让人声贴近、清晰,背景音乐保持轻柔,最后自然渐弱收尾。
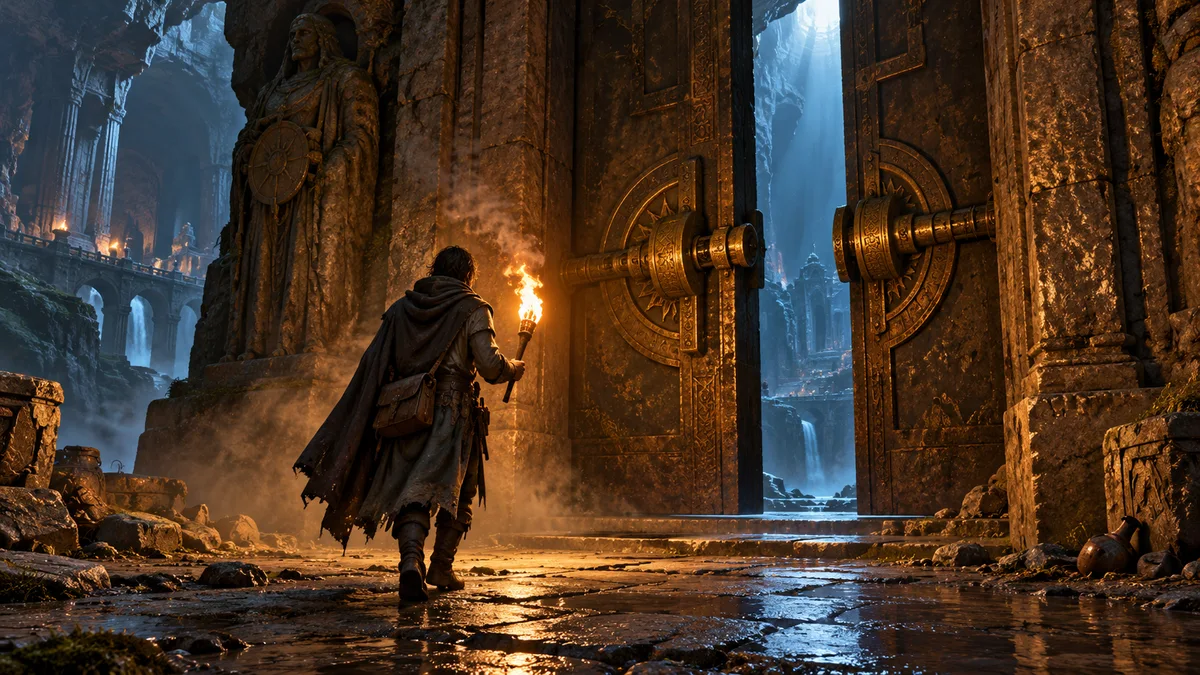
用脚步、锁扣和沉重石门的声音,表现角色进入地下遗迹的一刻。
写明材质、远近和空间感。可以用完整场景音轨做原型;需要在游戏中独立触发时,再分别生成每种音效。
生成一段 10 秒的冒险游戏地下遗迹音频。第 0–2 秒,皮靴缓缓踏过潮湿石板,近处有火把燃烧声。大约第 2 秒,铜制锁扣咔哒开启。第 3–6 秒,沉重石门缓缓摩擦移动,带着悠长回声。余下时间渐渐回到低弱的洞穴环境声。不要人声、台词和音乐。
把场景、说话者、准确台词、背景声和时间安排写在一起。音频参考按上传顺序使用 @音频1、@音频2、@音频3 引用。
写明总时长和每句台词的时间段,模型据此安排音频。需要精确到视频帧时,可在编辑器中进一步对齐。
下载 MP3、WAV 或 OGG Opus;开启字幕后,还可把返回的人声时间轴导出为 SRT,一起放入视频项目。
人物和周围声音需要一起生成时,使用场景音频;主要制作配音或歌曲时,可以选择独立的语音与音乐工具。
| 工具 | 适合任务 | 需要准备 | 输出内容 |
|---|---|---|---|
| Seed Audio 1.0 | 带环境声的对话、旁白与音效 | 场景描述,以及可选图片或音频参考 | 一条场景音轨,可选人声字幕 |
| 高级文字配音 | 按分段安排的旁白和配音文案 | 分段文案、音色与说话方式 | 可编排、导出的语音片段 |
| AI 音乐生成器 | 背景音乐与有歌词的歌曲 | 音乐描述、风格或歌词 | 用于视频项目的音乐或歌曲 |
写明环境与声音,把准确台词放进引号,交代每位角色的声音。
使用纯文字、1 张图片,或最多 3 条短音频,选择输出格式和字幕选项。
试听音频,按需调整场景描述,再下载音轨与可用的 SRT 字幕。
Seed Audio 1.0 是字节跳动的音频创作模型,面向完整场景的声音生成。可以用自然语言描述,把人声表演、音效、环境声和音乐元素组合在同一条音轨中。
可以。在提示词中写下准确台词,并描述说话者、情绪和语气。可以安排多个人物,也可以在同一份提示词里描述周围环境声。
在生成器中选择图片参考,上传 1 张不超过 10 MB 的 JPG、PNG 或 WebP,再填写需要的文本或声音描述。当前接入中,图片参考不能与音频参考或预设音色混用。
按照使用顺序上传,在提示词中用 @音频1、@音频2、@音频3 对应引用。每条不超过 30 秒、10 MB。选择已配置的预设音色时,会占用一个参考位置。
在提示词中描述总时长和每句台词的时间段,例如“生成 12 秒场景,第一位角色在第 2–5 秒说话”。原始音频最长 120 秒,这个页面不使用单独的时长参数。
当前 API 列出中文、英语、日语、韩语、墨西哥西班牙语、西班牙西班牙语、德语、法语、巴西葡萄牙语、泰语、越南语、马来语、菲律宾语、意大利语、俄语、荷兰语、波兰语和土耳其语。
生成器接收文字、单张图片或短音频参考。可以从视频截取关键帧作为图片参考。生成同步成片或修改人物口型,需要另外的视频工作流程。
生成器提供 MP3、WAV 和 OGG Opus 音频。开启字幕并收到人声时间戳后,可下载 SRT 文件。音频输出为一条合成音轨,不会分别导出对话、音乐和音效分轨。
生成器会在提交前展示当前积分单价,先按最长 120 秒预扣,再根据原始生成时长向上取整到秒结算,退还未使用积分。调整语速不改变计费用的原始时长。
资料核验于 2026-10-25。
从一句台词、一个场景和你想听到的声音开始。