對話 + 環境音
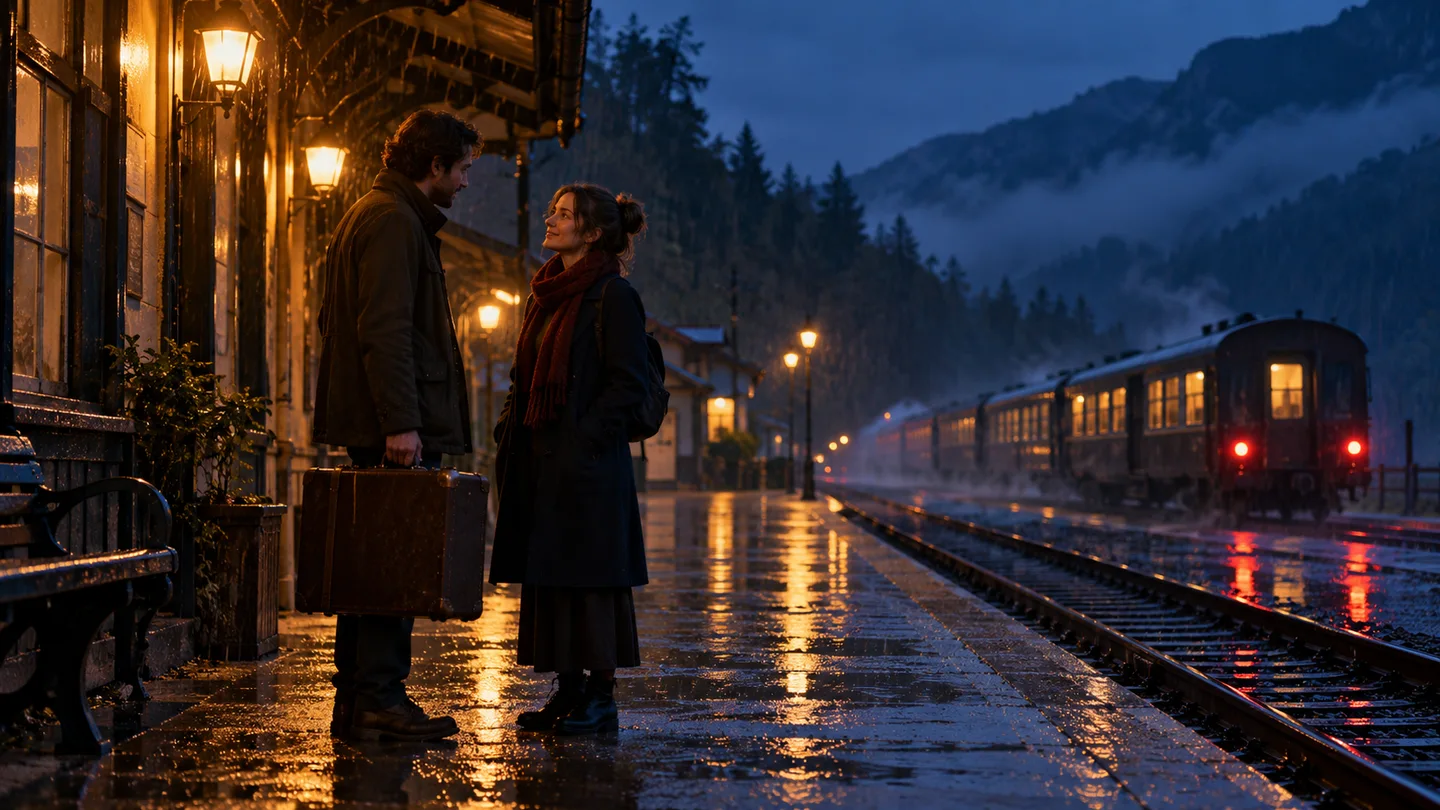
雨中站台对话
0:14生成一段 14 秒的黄昏火车站台场景。第 2–5 秒,女声温和地问:“这班车还要等多久?”第 6–10 秒,男声轻笑着回答:“大概二十分钟吧,正好陪你看会儿雨。”背景有持续的细雨声、远处列车进站的鸣笛和行李箱滚轮声。不要音乐。
位元組跳動 · 場景音訊生成
寫下台詞,也寫出聲音裡的世界
一段帶著咖啡館氛圍的對話,一句有雨聲陪伴的旁白,或一個動作發生時的音效。 Seed Audio 1.0 能根據場景描述,把語音、環境聲與聲音細節生成在同一條音軌裡。
使用 SEED AUDIO 1.0 創作
描述場景和準確台詞,按需添加參考素材,生成後即可試聽和下載。
音軌含有人聲台詞時,可下載附時間軸的字幕。
在這裡試聽你的場景
生成後可在這裡試聽、下載音頻,並匯出字幕。
真實生成音訊
以下音訊全部由 PixMind 上的 Seed Audio 1.0 從一段文字提示詞直接生成,未經剪輯。複製提示詞即可重現場景。
對話 + 環境音
生成一段 14 秒的黄昏火车站台场景。第 2–5 秒,女声温和地问:“这班车还要等多久?”第 6–10 秒,男声轻笑着回答:“大概二十分钟吧,正好陪你看会儿雨。”背景有持续的细雨声、远处列车进站的鸣笛和行李箱滚轮声。不要音乐。
旁白解說
生成一段 12 秒的深夜城市天台旁白。第 2–10 秒,低沉的男声缓缓地说:“凌晨两点的城市终于安静下来,霓虹在雾气里晕开,像一场不肯醒来的梦。”背景有轻柔的风声、远处的车流声和偶尔的风铃轻响。不要音乐。
廣告配音
生成一段 12 秒的智能手表广告配音。第 2–6 秒,充满活力的女声说:“全新 AirFit 手表,十四天超长续航,健康监测一步到位。”第 7–10 秒,她加重语气说:“现在下单,立减两百。”背景有轻快的电子提示音和收尾的清脆叮声。不要响亮的音乐。
音效擬音
生成一段 10 秒的清晨早餐铺声音。第 1–3 秒,油锅里的油条滋滋作响。第 4–6 秒,蒸笼掀开,白雾腾起伴着轻响。第 7–9 秒,远处传来自行车铃铛和邻桌瓷碗轻碰声。不要人声对白,不要音乐。
一個場景,多種聲音
把人物表演和周圍環境放在一起描述,可以從下面的提示詞開始,改成自己的場景。
圖片用於展示場景與提示詞思路,並非模型產生的音訊結果。
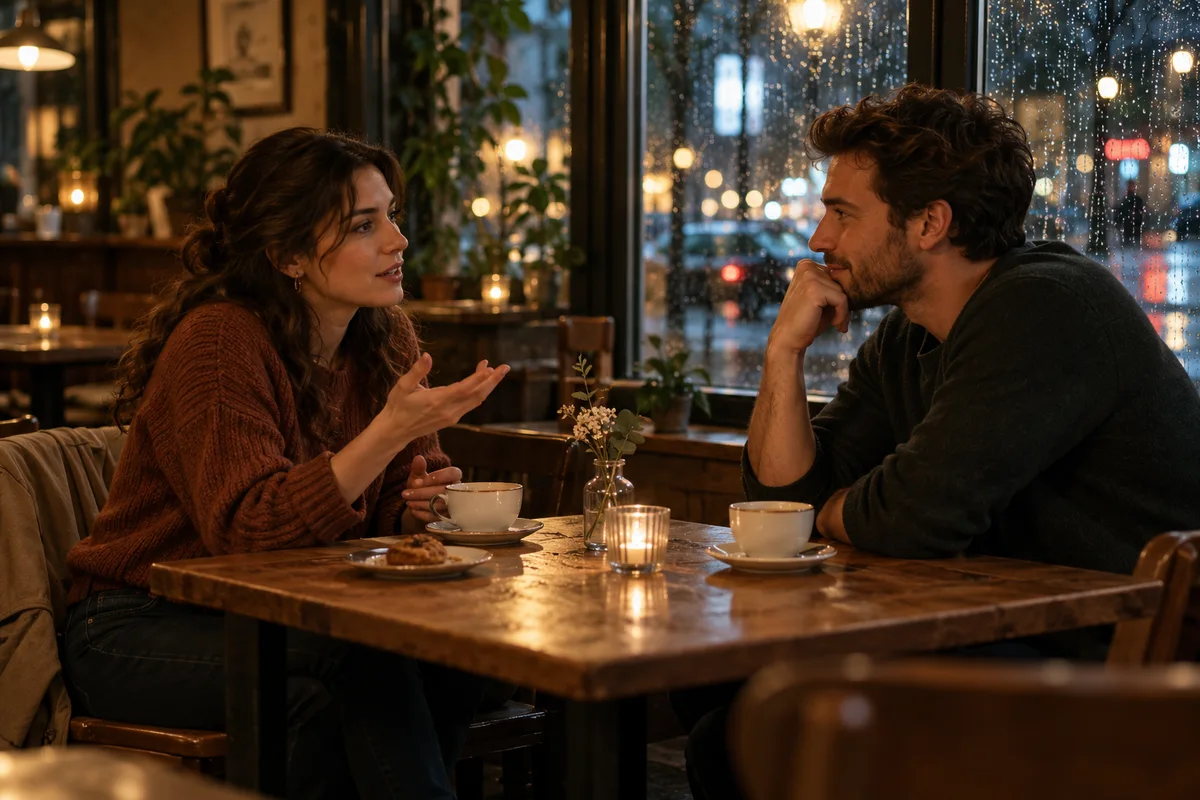
角色對話 + 環境氛圍
安靜的咖啡館、熱鬧的街道、空曠的大廳,會讓同一句對話聽起來不一樣。
寫明每個角色的台詞、聲音和說話方式,再補充周圍的聲音。 Seed Audio 可以把對話和背景氛圍一同生成在一條音軌裡。
產生一段 12 秒的咖啡館場景。第 2–5 秒,女生輕聲問:「我們在這裡等等吧?」第 6–9 秒,男生回答:「等雨停了再走。」窗外有輕柔雨聲,室內有輕微杯碟聲和低弱環境聲。不要響亮的音樂。
圖片參考生成音頻
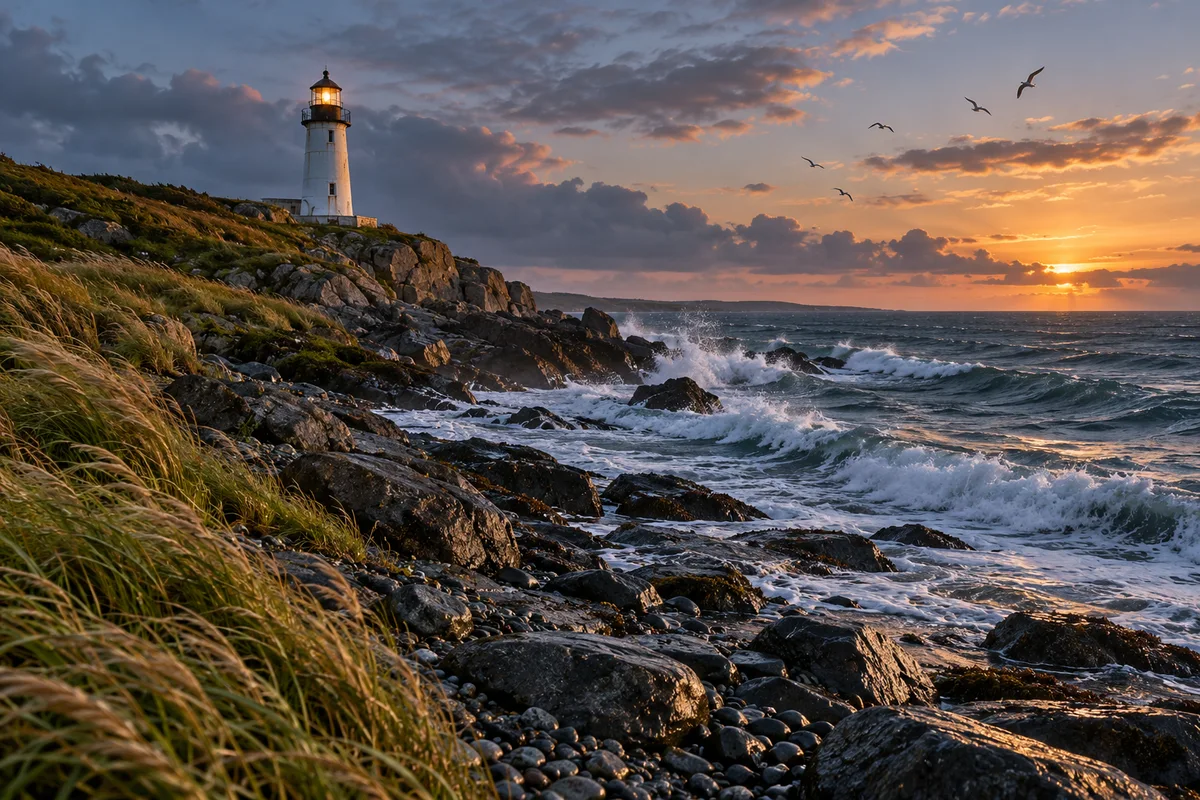
一片海岸,能讓人聯想到風、海浪和遠處的海鳥。
上傳一張圖片,引導音訊生成,再寫下需要的聲音或台詞。也可以截取影片關鍵影格作為參考,生成後把音軌加入自己的剪輯。
為這張圖片產生 15 秒的海岸環境聲。風吹過草叢,海浪拍打礁石,遠處偶爾傳來海鷗叫聲。不要人聲和音樂,讓浪聲自然起伏漸弱。
動作音效 + 時間安排
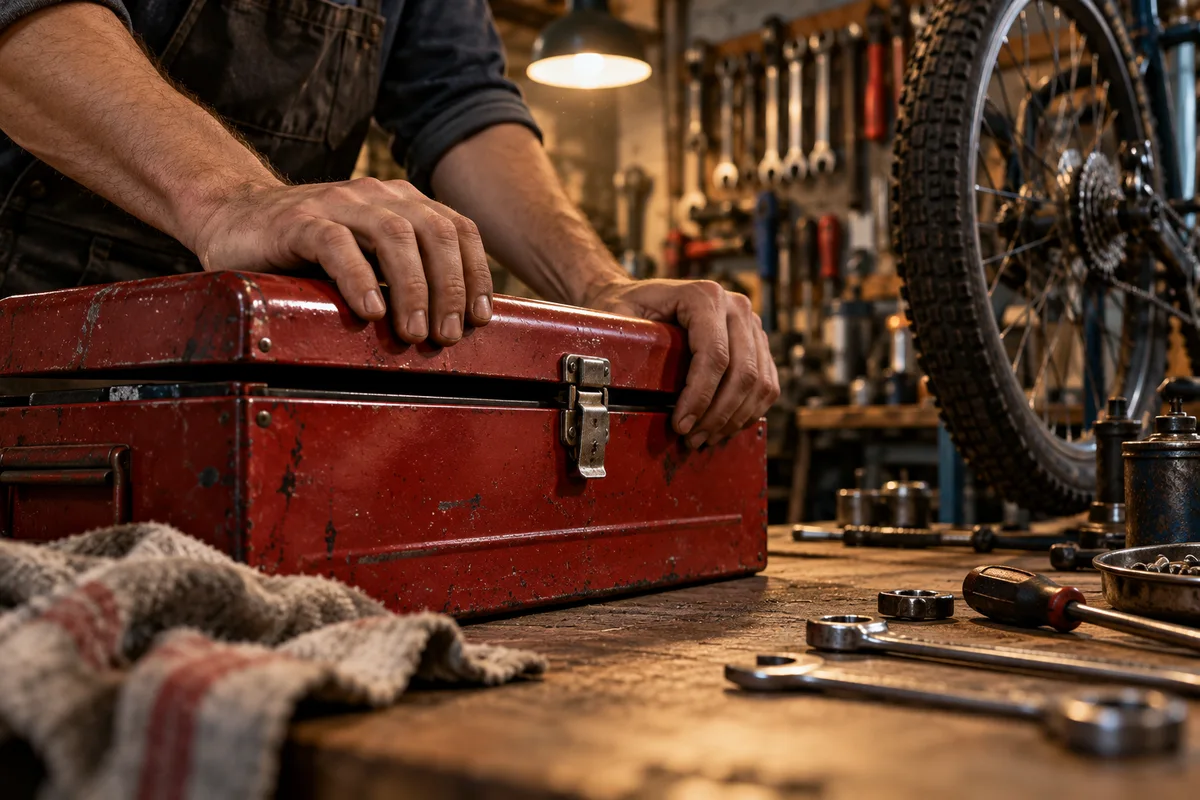
鎖扣輕響,工具箱合上,房間又回到安靜的背景聲。
描述物件、動作、材質和空間,塑造所需的音效。用自然語言寫下時長與聲音出現的時間,也可以單獨產生一個聲音,再加入更完整的片段。
產生一段 8 秒的自行車維修間聲音。大約第 2 秒,金屬鎖扣咔噠一響。大約第 3 秒,紅色鐵皮工具箱合上,發出堅固的撞擊聲。幾件工具輕輕晃動,隨後回到安靜的室內環境聲。不要人聲和音樂。
場景應用案例
按你要完成的任務選擇案例。每個案例都提供參考畫面、聲音安排和可改寫的提示詞,方便直接用於音訊創作。
以下是場景參考與聲音腳本思路,可在上方生成器中產生並試聽自己的音訊。
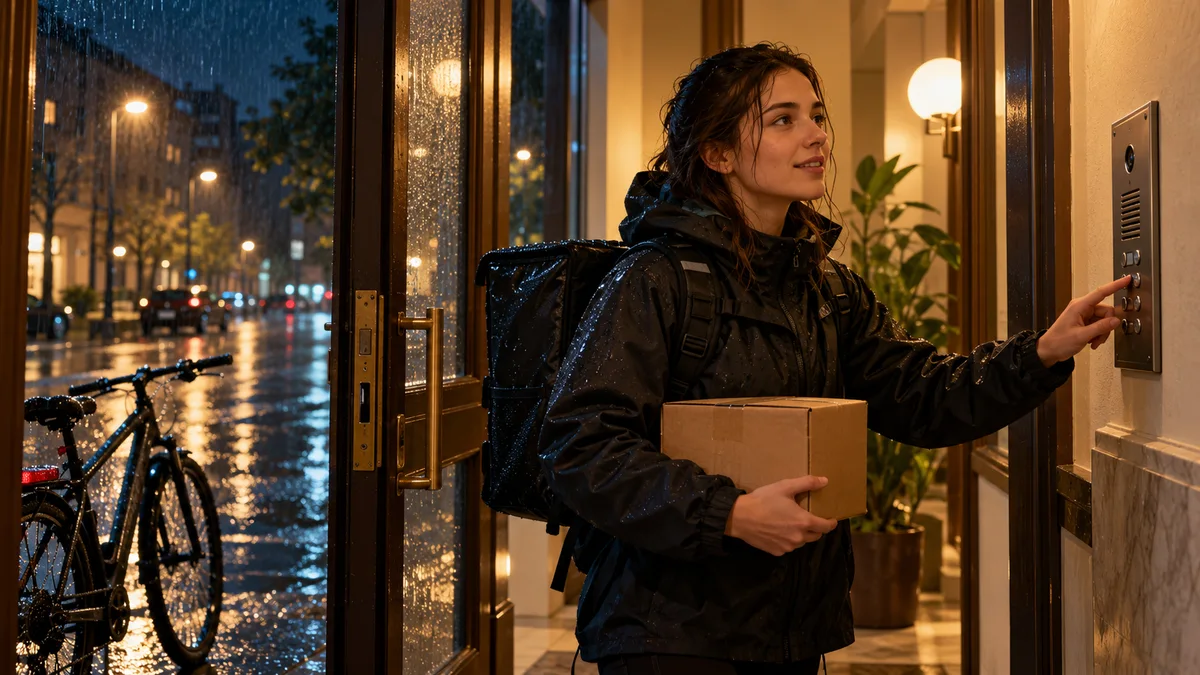
为一段雨夜送货镜头补上台词、脚步和环境声,交代时间、地点与人物动作。
可以截取影片關鍵影格作為圖片參考,產生後把音軌放到原影片下方,在編輯器中調整時間位置。
產生一段 12 秒的中文雨夜送貨場景。第 0–2 秒是輕柔雨聲、濕地腳步聲,隨後自行車停下。第 2–5 秒,女生清晰地說:「您的快遞到了。」第 6–9 秒,對講機傳來溫和男聲:「謝謝,進來吧。」最後加入輕微開門聲。讓雨聲保持在人聲之下,不要音樂。
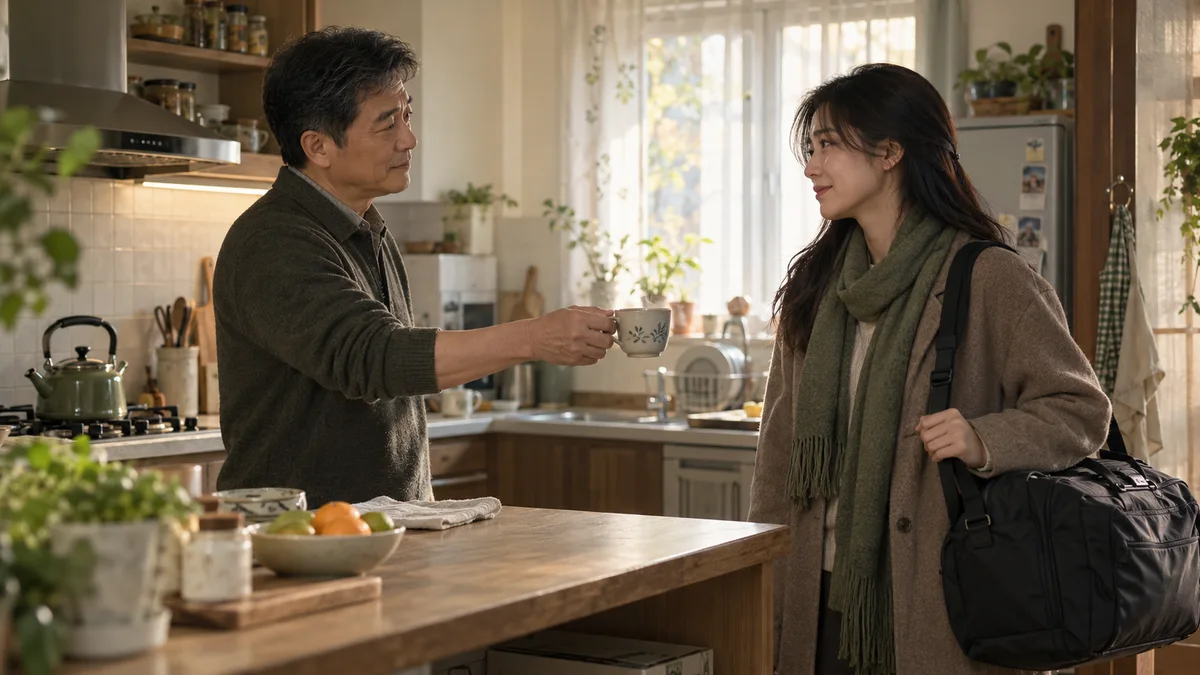
讓父女告別的一小段對話帶上各自的聲音、自然停頓和廚房背景。
在提示詞中分別交代人物的聲音和說話方式。需要用聲音樣本保持角色音色時,切換到音訊參考模式,依上傳順序引用樣本。
產生一段 14 秒的中文生活短劇場景。中年父親的聲音低沉溫和,成年女兒的聲音清晰、放鬆。背景有輕微燒水聲和廚房環境聲。第 2–5 秒,父親輕聲問:「東西都帶齊了?」第 6–10 秒,女兒帶著笑意回答:「就差你泡的這杯茶。」稍作停頓後,有輕輕放下茶杯的聲音。背景保持克制,不要音樂。
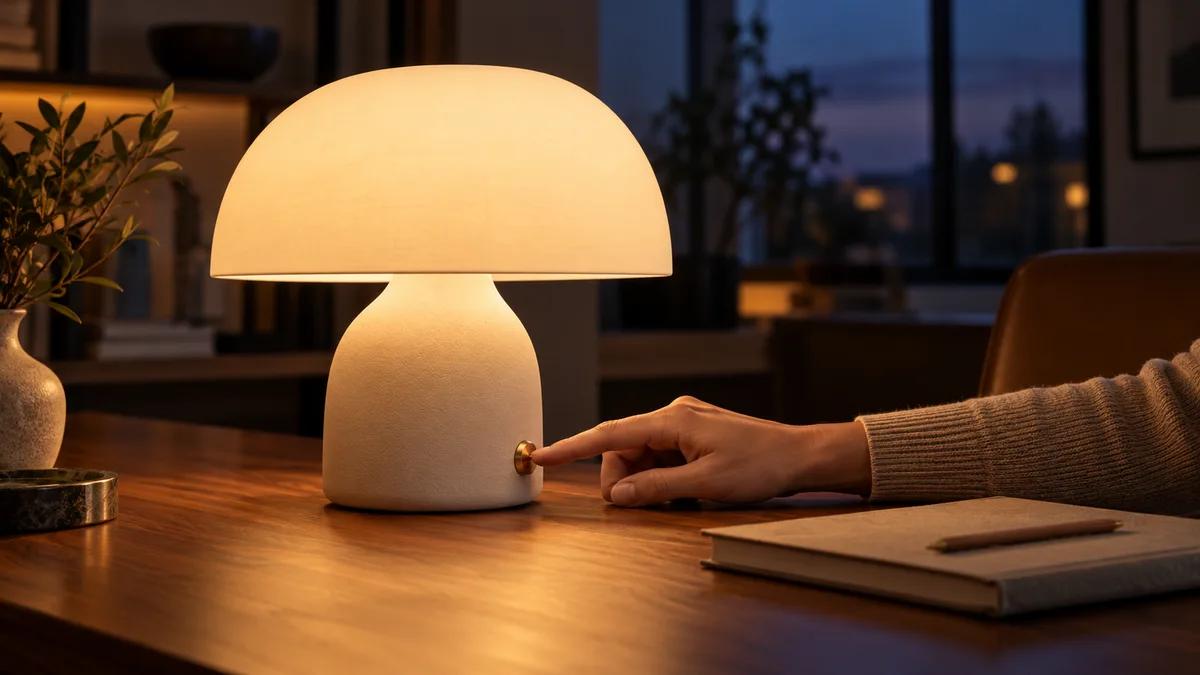
用一段簡短旁白、一次開關聲和輕柔配樂,為檯燈宣傳片搭好聲音。
把準確廣告文案放進引號,說明音樂應低於人聲。產生後下載音軌和可用的 SRT 字幕,再與產品鏡頭合成。
產生一段 12 秒的中文檯燈廣告音訊。大約第 1 秒有輕微金屬開關聲,隨後簡潔、輕柔的純音樂漸入。第 2–9 秒,平靜、自信的女生說:「一束剛好的光,一點思考的空間。把時間,留給重要的事。」讓人聲貼近、清晰,背景音樂保持輕柔,最後自然漸弱收尾。
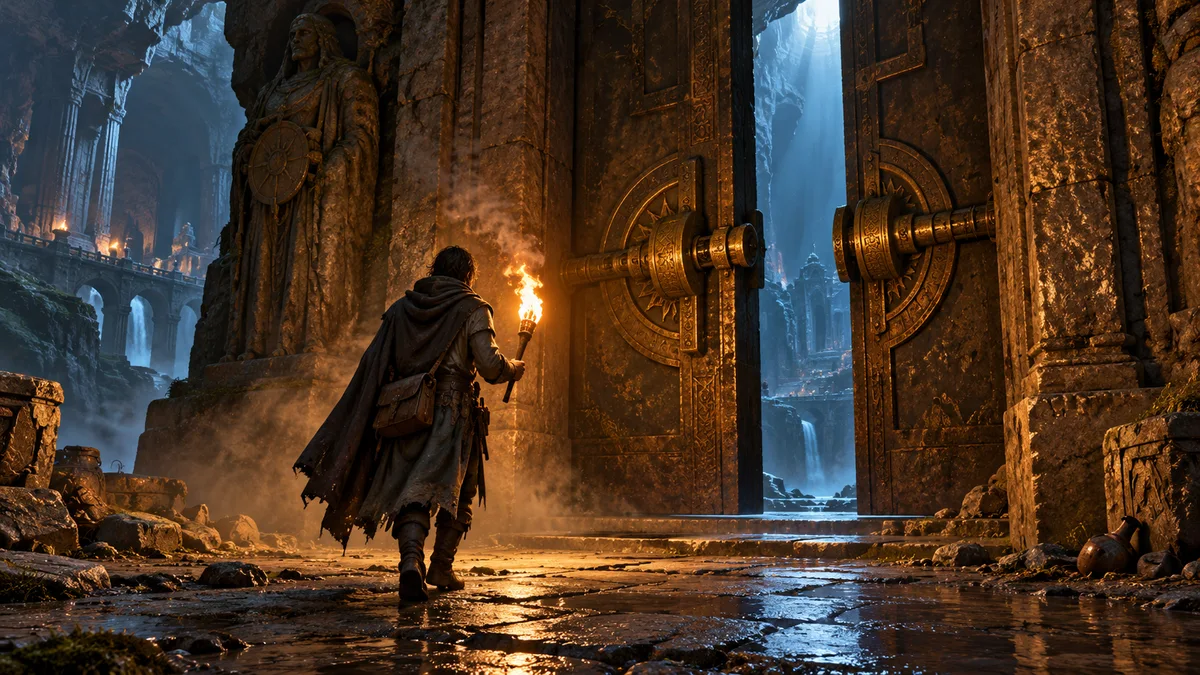
用腳步、鎖扣和沈重石門的聲音,表現角色進入地下遺跡的一刻。
寫明材質、遠近和空間感。可以用完整場景音軌做原型;需要在遊戲中獨立觸發時,再分別產生每種音效。
產生一段 10 秒的冒險遊戲地下遺跡音訊。第 0–2 秒,皮靴緩緩踏過潮濕石板,近處有火把燃燒聲。大約第 2 秒,銅製鎖扣咔噠開啟。第 3–6 秒,沉重石門緩緩摩擦移動,帶著悠長迴音。餘下時間漸漸回到低弱的洞穴環境聲。不要人聲、台詞和音樂。
把场景、说话者、准确台词、背景声和时间安排写在一起。音频参考按上传顺序使用 @音频1、@音频2、@音频3 引用。
寫明總時長和每句台詞的時間段,模型據此安排音頻。需要精確到視訊幀時,可在編輯器中進一步對齊。
下載 MP3、WAV 或 OGG Opus;開啟字幕後,還可將返回的人聲時間軸匯出為 SRT,一起放入影片專案。
人物和周圍聲音需要一起產生時,使用場景音訊;主要製作配音或歌曲時,可以選擇獨立的語音與音樂工具。
| 工具 | 適合任務 | 需要準備 | 輸出內容 |
|---|---|---|---|
| Seed Audio 1.0 | 帶有環境聲的對話、旁白與音效 | 場景描述,以及可選圖片或音訊參考 | 一場景音軌,可選人聲字幕 |
| 高級文字配音 | 按分段安排的旁白和配音文案 | 分段文案、音色與說話方式 | 可編排、導出的語音片段 |
| AI 音樂生成器 | 背景音樂與有歌詞的歌曲 | 音樂描述、風格或歌詞 | 用於影片專案的音樂或歌曲 |
寫明環境與聲音,把準確台詞放進引號,交代每位角色的聲音。
使用純文字、1 張圖片,或最多 3 個短音頻,選擇輸出格式和字幕選項。
試聽音頻,按需調整場景描述,再下載音軌與可用的 SRT 字幕。
Seed Audio 1.0 是位元組跳動的音訊創作模型,面向完整場景的聲音產生。可以用自然語言描述,把人聲表演、音效、環境聲和音樂元素組合在同一條音軌中。
可以。在提示詞中寫下準確台詞,並描述說話者、情緒和語氣。可以安排多個人物,也可以在同一份提示詞中描述周圍環境聲。
在生成器中選擇圖片參考,上傳 1 張不超過 10 MB 的 JPG、PNG 或 WebP,再填寫所需的文字或聲音描述。在目前存取中,圖片參考不能與音訊參考或預設音色混用。
依使用順序上傳,在提示詞中以 @音频1、@音频2、@音频3 對應引用。每條不超過 30 秒、10 MB。選擇已配置的預設音色時,會佔用一個參考位置。
在提示詞中描述總時長和每句台詞的時間段,例如「生成 12 秒場景,第一位角色在第 2–5 秒說話」。原始音訊最長 120 秒,這個頁面不使用單獨的時長參數。
目前 API 列出中文、英語、日語、韓語、墨西哥西班牙語、西班牙西班牙語、德語、法語、巴西葡萄牙語、泰語、越南語、馬來語、菲律賓語、義大利語、俄語、荷蘭語、波蘭語和土耳其語。
生成器接收文字、單張圖片或短音訊參考。可以從影片截取關鍵影格作為圖片參考。產生同步成片或修改人物口型,需要另外的視訊工作流程。
生成器提供 MP3、WAV 和 OGG Opus 音訊。開啟字幕並收到人聲時間戳記後,可下載 SRT 檔案。音訊輸出為合成音軌,不會分別匯出對話、音樂和音效分軌。
生成器會在提交前顯示當前積分單價,先按最長 120 秒預扣,再根據原始生成時長向上取整到秒結算,退還未使用積分。調整語速不改變計費用的原始長度。
資料核驗於 2026-10-25。
從一句台詞、一個場景和你想聽到的聲音開始。